A modular calibrating AI reviewer for ranking scientific papers (Flash paper)
УДК 004.8; 519.816
Аннотация
Представлена модульная архитектура калибровочного ИИ-рецензента, состоящая из шести независимых модулей, последовательно реализующих определение режима рецензирования (STEM/Humanities), оценку научной новизны, методологическую строгость, практическую ценность, качество визуализации и воспроизводимость. ИИ-рецензент предлагается как инструмент первичной экспресс-фильтрации рукописей, поступающих в редакцию. Валидация архитектуры (DeepSeek-V3, 10 прогонов на 7 статьях) с урезанным средним подтвердила снижение вариативности LLM: коэффициент вариации (CV) сильных работ составил 2–3 %. В ходе инвертированного теста Тьюринга ИИ распознал сгенерированный абсурдный текст, присвоив ему минимальный балл (21.62 из 100) при диагностически высоком CV (28.2 %). Дополнительно в рамках работы апробирован формат Flash-статьи: данная статья-якорь обеспечивает видимость в каталогах и цитируемость, полный текст статьи с дополнительными материалами (логи верификации, код) размещён в репозиториях (SSRN, Zenodo с DOI) и на GitHub. Формат сокращает цикл публикации с 6–12 месяцев до 2–4 недель и предназначен для оперативного представления результатов в журналах с ускоренным рецензированием и печатью, что особенно востребовано в быстроразвивающихся научных областях и прикладных исследованиях.
Abstract
A modular architecture of a calibrating AI reviewer is presented, consisting of six independent modules that sequentially implement the determination of the review mode (STEM/Humanities), assessment of scientific novelty, methodological rigor, practical value, visualization quality, and reproducibility. The AI reviewer is proposed as a tool for primary express filtering of manuscripts submitted to an editorial office. Validation of the architecture (DeepSeek-V3, 10 runs on 7 papers) with a trimmed mean confirmed a reduction in LLM variability: the coefficient of variation (CV) for strong papers was 2–3 %. In an inverted Turing test, the AI recognized the generated absurd text, assigning it a minimum score (21.62 out of 100) with a diagnostically high CV (28.2 %). Additionally, the Flash Paper format was tested within the framework of this work: the anchor paper ensures visibility in catalogs and citability, while the full text of the article with supplementary materials (verification logs, code) is deposited in repositories (SSRN, Zenodo with DOI) and on GitHub. The format reduces the publication cycle from 6–12 months to 2–4 weeks and is intended for the prompt presentation of results in journals with accelerated review and printing, which is especially in demand in fast-moving scientific fields and applied research.
Ключевые слова: калибровочный ИИ-рецензент; модульная архитектура; Flash-статья; оперативная публикация; тест Тьюринга.
Keywords: calibrating AI reviewer; modular architecture; Flash Paper; rapid publication; Turing test.
Введение
Актуальность. Экспоненциальный рост научных публикаций [9], и перегрузка экспертов делают необходимыми инструменты автоматизированной предварительной оценки рукописей. Существующие ИИ-рецензенты страдают контекстной зависимостью [3, 4], стохастической нестабильностью [1], они оценивают работу в рамках имеющейся информации [11], тогда как новаторские идеи могут выходить за эти пределы.
Проблема усугубляется издательским лагом: традиционный цикл рецензирования занимает 6–12 месяцев, за которые исследование теряет актуальность. По этой причине в настоящей работе впервые использован формат, названный Flash Paper: препринт представляет полные материалы [7], Github (https://github.com/Famimot/calibrating-ai-reviewer-modular) обеспечивает воспроизводимость результатов, а данная якорная статья с коротким сроком публикации обеспечивает лаконичное и своевременное представление информации.
Простая генерация оценок работы ИИ-рецензента без раскрытия исходных материалов не имеет доказательной силы, а одиночный прогон LLM некорректен в силу стохастической природы модели — необходимы многократные измерения с фильтрацией выбросов.
В прошлой работе [6] предложен монолитный ИИ-рецензент на базе конкурентного ранжирования в замкнутом пакете. Цель работы — спроектировать и валидировать архитектуру из 6 специализированных модулей, отвечающих за отдельный критерий статьи [9, 7]. Валидация проведена на контрастном массиве из 7 статей: 6 реальных публикаций автора с открытым DOI (исключает конфликт интересов) и 1 сгенерированной LLM абсурдной работы (DOI: 10.5281/zenodo.20703374) для инвертированного теста Тьюринга [2]. Это гарантирует полную прозрачность и воспроизводимость, в отличие от исследований на закрытых массивах. Для каждой статьи выполнено 10 прогонов DeepSeek-V3 с расчетом урезанного среднего для фильтрации выбросов.
Бонусный эксперимент проверил способность ИИ распознавать семантический абсурд в формально корректном тексте.
Методология
Принцип калибровки. Рецензент оценивает не отдельную статью по абсолютной шкале, а весь массив одновременно: статьи выступают шкалой друг для друга. Сильная работа получает высокий балл потому, что превосходит остальные, слабая — потому что уступает. Это снимает проблему отсутствия у LLM абсолютной шкалы. Урезанное среднее по 10 прогонам фиксирует устойчивую калибровку, отбрасывая стохастические отклонения.
Архитектура. Выделены фундаментальные сущности оценки научной рукописи, определены их числовые шкалы [5, 8]. Архитектура включает шесть модулей (табл. 1), выполняющих определённую функцию. Это обеспечивает поэтапный контроль корректности, локализацию ошибок и возможность модификации отдельных модулей без переписывания всей системы. Полное описание логики, чек-листов и промптов — в открытом репозитории [7].
Таблица 1.
Модульная структура ИИ-рецензента
| Модуль | Название | Функция | Баллы |
|---|---|---|---|
| 1 | Режим-детектор | Определение STEM/Humanities | 0 |
| 2 | Новизна-анализатор | Оценка новизны, происхождения метода | 30 |
| 3 | Методология-анализатор | Оценка методологической строгости | 25 |
| 4 | Ценность-анализатор | Оценка практической ценности | 20 |
| 5 | Визуализация, воспроизводимость | Оценка визуализации и воспроизводимости | 15 + 10 |
| 6 | Агрегатор-категоризатор | Категоризация, итоговая таблица | 100 |
Процедура рецензирования. Для каждой из R = 10 итераций в «чистом» диалоге с LLM (DeepSeek-V3) последовательно выполняются модули 1–6. Каждый последующий модуль использует результаты предыдущих. Фиксируется итоговая таблица с баллами (0–100) для всех статей. После завершения 10 прогонов исключаются два минимальных и два максимальных значения для каждой статьи, вычисляется урезанное среднее [8]:
Rtrim — множество прогонов, исключающих два минимальных и два максимальных значения .
Rtrim — множество прогонов, исключающих два минимальных и два максимальных значения .
Финальный балл рассчитывается как сумма оценок по пяти критериям.
Верификация. Надёжность валидации обеспечивается не количеством статей, а кратным повторением прогонов (R = 10) с фильтрацией выбросов.
Результаты
Ранжирование. После фильтрации получены итоговые баллы для каждой статьи (табл. 2).
Таблица 2.
Результаты 10 прогонов (отфильтрованные данные)
| Статья | Новизна (30) |
Методология (25) |
Практ. Ценность (20) |
Визуализация (15) |
Воспроизв. (10) |
Итог (100) |
|---|---|---|---|---|---|---|
| 2 | 27.83 | 24.17 | 17.33 | 13.67 | 8.67 | 91.67 |
| 7 | 27.33 | 24.17 | 15.17 | 12.67 | 9.5 | 88.83 |
| 5 | 28.17 | 24 | 13.5 | 12.33 | 8.83 | 86.83 |
| 3 | 25 | 23.83 | 11.5 | 12.5 | 5.83 | 78.67 |
| 1 | 25 | 24 | 11 | 12.67 | 5.67 | 78.33 |
| 4 | 17.5 | 16.67 | 6 | 10.5 | 5.5 | 56.17 |
| 6 | 3.8 | 5.67 | 2.4 | 7.5 | 2.25 | 21.62 |
ИИ-рецензент продемонстрировал устойчивую дифференциацию статей. Разрыв между лучшей работой (91.67) и сгенерированной статьёй (21.62) составил 70 баллов. Распределение итоговых баллов до и после фильтрации представлено на рис. 1 (полные данные всех визуализаций — в препринте [7]).
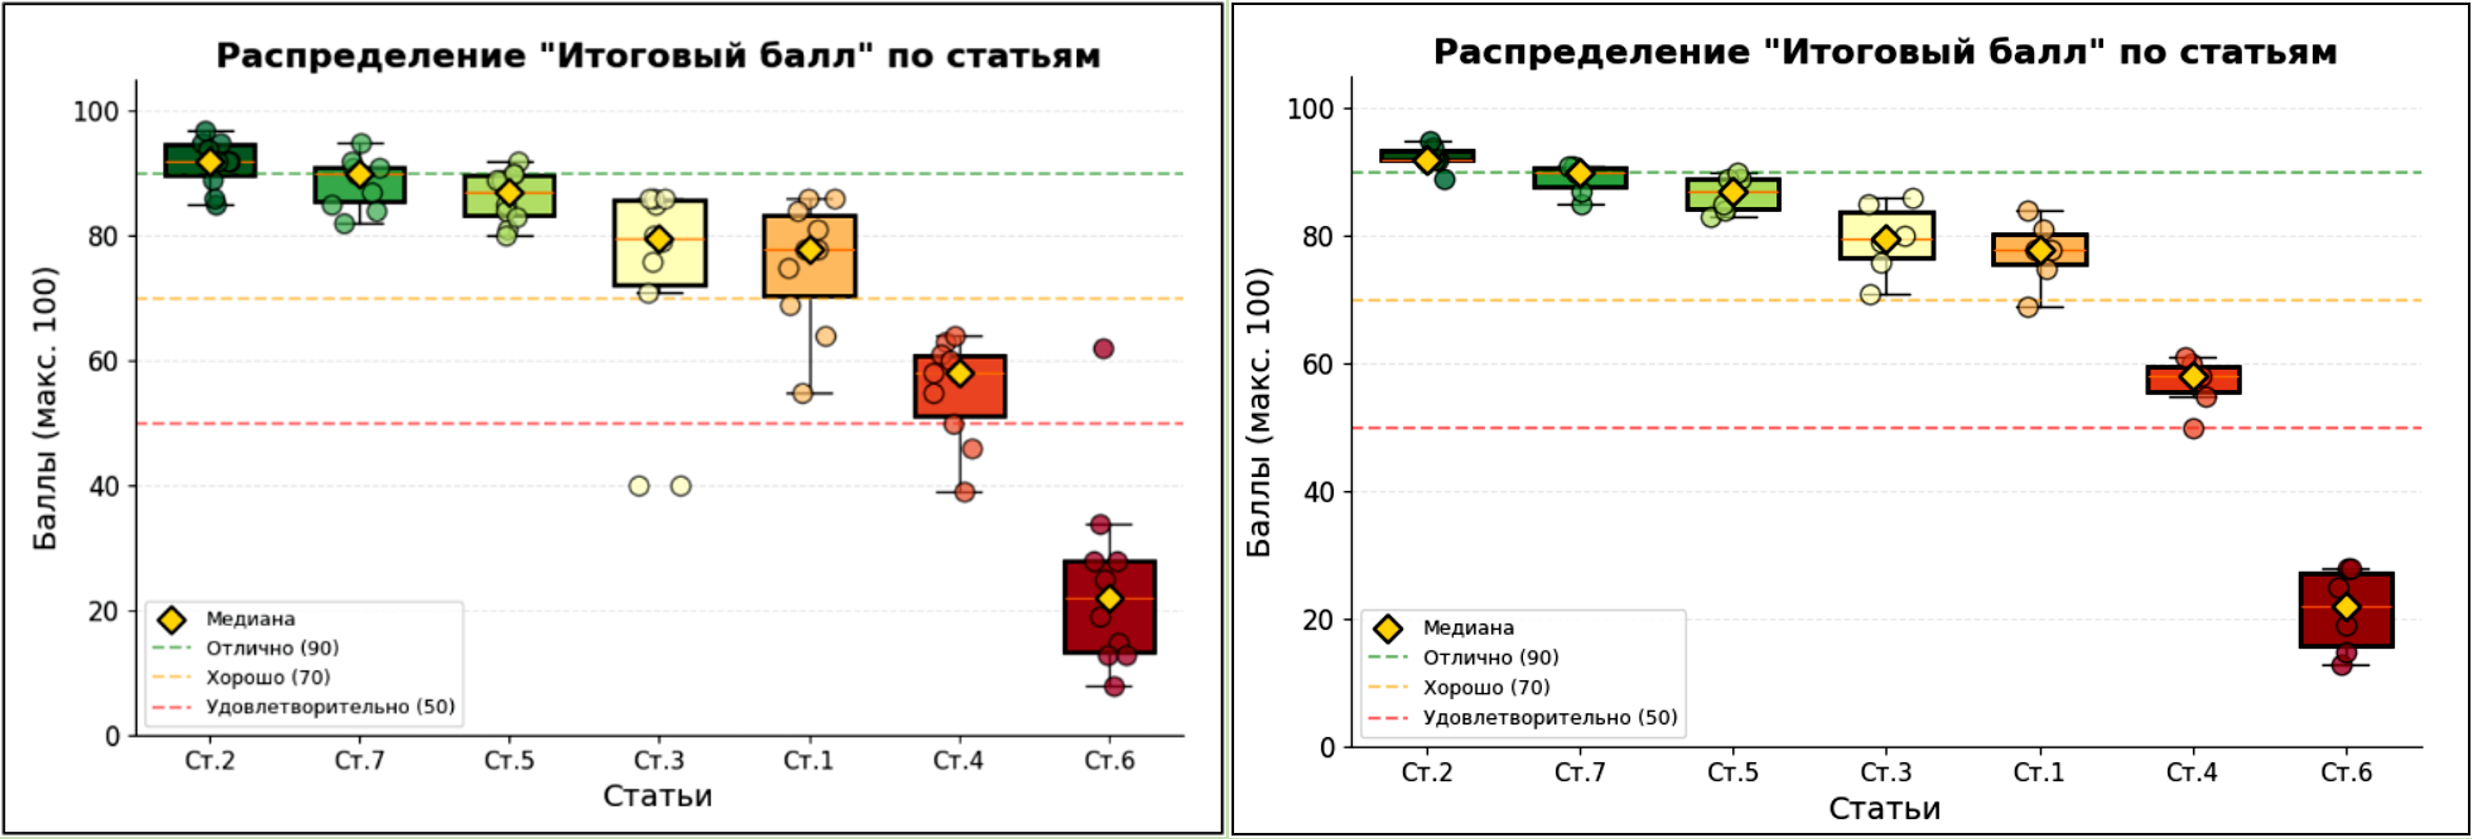
Коэффициент вариации (CV) для сильных статей составляет 2–3 %, для статей средней группы — 6–6.5 %. Для сгенерированной статьи CV = 28.2 % (табл. 3), что более чем в 10 раз превышает CV сильных статей.
Таблица 3.
Вариативность результатов
| Paper | Mean | Median | Min | Max | Range | Std | CV (%) |
|---|---|---|---|---|---|---|---|
| 2 | 92.33 | 92 | 89 | 95 | 6 | 1.89 | 2.04 |
| 7 | 89 | 90 | 85 | 91 | 6 | 2.24 | 2.51 |
| 5 | 86.67 | 87 | 83 | 90 | 7 | 2.75 | 3.17 |
| 3 | 79.5 | 79.5 | 71 | 86 | 15 | 5.12 | 6.44 |
| 1 | 77.5 | 78 | 69 | 84 | 15 | 4.72 | 6.09 |
| 4 | 57 | 58 | 50 | 61 | 11 | 3.65 | 6.41 |
| 6 | 21.33 | 22 | 13 | 28 | 15 | 6.02 | 28.21 |
Воспроизводимость. Все материалы размещены в открытом доступе: дополнительные материалы (скрипт, верификация) [7],
модульные промпты (рус./англ.),— https://github.com/Famimot/calibrating-ai-reviewer-modular,
текст сгенерированной ИИ статьи — https://doi.org/10.5281/zenodo.20703374,
определение Flash-статьи — https://doi.org/10.5281/zenodo.22727742.
Заключение
Разработанная модульная архитектура подтверждает свою эффективность: формализация критериев в виде модульного конвейера обеспечивает поэтапную локализацию ошибок и возможность модификации отдельных модулей.
Ключевые выводы
1. Калибровочный режим. Оценка отдельной рукописи нестабильна из-за стохастической природы LLM. Предпочтителен режим сравнения, где статьи сами выступают калибровочным материалом.
2. Многократность прогонов. Необходимо выполнять несколько независимых прогонов с фильтрацией экстремумов.
3. Дискриминативная способность. Инструмент устойчиво дифференцирует статьи.
4. Практическая ценность. Инструмент предназначен для первичной фильтрации рукописей и снижения нагрузки на экспертов [3], ранжирования журналов [10], а также самооценки.
Представленный подход демонстрирует полную открытость, воспроизводимость и практическую применяемость в отличие от закрытых систем, не предоставляющих исходных данных для верификации. В то же время использованный формат Flash-статьи позволяет опубликовать работу через несколько недель, а не 6–18 месяцев, без потери актуальности и практической ценности.
Список литературы
References
